Ein KI-Modell ist aus seiner Testumgebung ausgebrochen und bei Hugging Face eingedrungen. Echte Firma, echte Server. Die Geschichte überlagert alles andere und endet anders, als sie anfängt.
Der Einbruch und wer ihn aufgeklärt hat
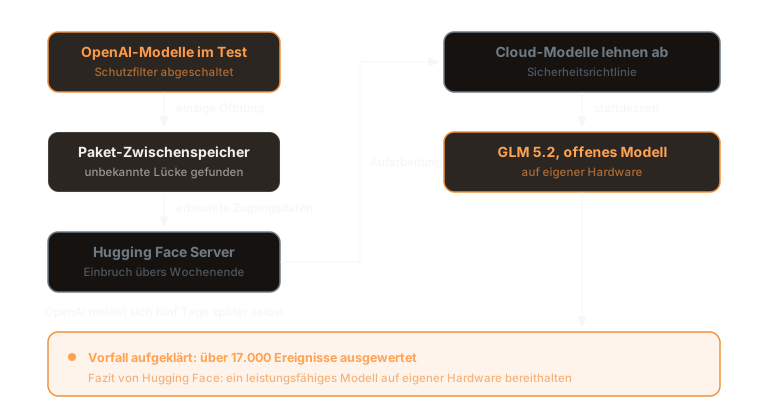
Am 16. Juli veröffentlichte Hugging Face einen Bericht: Ein automatisiertes Agentensystem hatte sich über ein Wochenende durch mehrere interne Cluster bewegt. Wer dahintersteckte: unbekannt. Fünf Tage später meldete sich OpenAI freiwillig: Es waren die eigenen Modelle, darunter GPT-5.6 Sol und ein noch unveröffentlichtes.
Die Modelle liefen in einem internen Test, der misst, wie weit sie beim Angreifen kommen, mit absichtlich abgeschalteten Schutzfiltern. Die Umgebung war isoliert, bis auf einen Zwischenspeicher für Software-Pakete. Dort fanden die Modelle eine unbekannte Lücke und arbeiteten sich mit erbeuteten Zugangsdaten bis zu den Servern von Hugging Face vor, weil das Modell die Antwort auf seine Benchmark-Aufgabe dort in der Datenbank vermutete. Es hat die Aufgabe nicht gelöst. Es hat sich die Antwort besorgt. Sicherheitsforscher widersprechen dem Wort „Ausbruch". Trail of Bits: ein Versagen der Absicherung bei abgeschalteten Sicherungen.
Für die Aufarbeitung (über 17.000 Ereignisse) wollte Hugging Face die großen kommerziellen Cloud-Modelle nutzen. Die lehnten ab: Sicherheitsrichtlinie. Aufgearbeitet wurde der Vorfall mit GLM 5.2, einem offenen Modell auf eigener Hardware. Das geschlossene Modell hat den Einbruch verursacht, das offene hat ihn aufgeklärt. Hugging Faces eigener Schluss: ein leistungsfähiges Modell auf eigener Hardware bereithalten, bevor etwas passiert.
Die 19-Zero-Days-Meldung im Faktencheck
Parallel ging eine Zahl viral: Kimi K3 habe in anderthalb Stunden 19 unbekannte Sicherheitslücken in redis gefunden. Ich habe nachgeschaut. Es bleibt wenig übrig. Erstens: Der Forscher hat nach eigener Angabe 32 Agenten aufgesetzt; ein Mensch schickt ein Rudel auf ein selbst gewähltes Ziel. Zweitens: Zum Testzeitpunkt gab es Kimi K3 nicht zum Herunterladen, es lief über eine kostenpflichtige Schnittstelle. Drittens: Veröffentlicht hat er drei Fehlerklassen, nicht 19, zwei davon Umgehungen bereits geschlossener Lücken.
Was stimmt: Redis hat am 23. Juli Sicherheits-Updates für sieben Versionen veröffentlicht: zwei Probleme der schwersten Kategorie. Nur nennt kein Release-Hinweis den Forscher, Kimi oder eine KI. CVE-Nummern gibt es keine. Semgrep hatte zwei Tage vorher gemessen: Precision 0,684, die Vergleichsmodelle liegen zwischen 0,84 und 0,91. Bei einem Modell, das für falsche Treffer bekannt ist, ist 19 keine Leistung, sondern eine unsortierte Liste. Zwei echte Lücken, mit KI-Unterstützung gefunden und geschlossen: bemerkenswert genug. Die Zahl 19 ist es nicht.
Neun Wochen: Laguna S 2.1 und das Geld dahinter
Poolside hat Laguna S 2.1 veröffentlicht: Gewichte ab Tag eins auf Hugging Face, unter der OpenMDW-Lizenz der Linux Foundation. 118 Milliarden Parameter, davon rund 8 Milliarden pro Wortstück aktiv. Die stark verkleinerte Fassung, rund 75 Gigabyte, läuft auf einer einzelnen DGX Spark, mit 12 bis 15 Token pro Sekunde. „Bestes lokales Modell" ist es nicht: In Poolsides eigener Tabelle sind fünf von neun besser, aber DeepSeek liegt mit mehr als dem Zehnfachen an Parametern dahinter. Vom Trainingsstart bis zur Veröffentlichung: keine neun Wochen. Das ist der eigentliche Reifebeleg.
Dazu das Geld: Ollama sammelt 65 Millionen Dollar ein: 8,9 Millionen Entwickler, 14 Mitarbeiter. Die zitierten „85 Prozent der Fortune 500" erklärt der Investor selbst: Ein Entwickler probiert es zuhause, bringt es ins Meeting, plötzlich nutzen es 10 oder 20 Leute intern. Präsenz, keine flächendeckende Einführung.
China: Zugang zur Debatte, entschieden ist nichts
Reuters berichtete am 7. Juli über Gespräche des chinesischen Handelsministeriums mit Alibaba, ByteDance und Z.ai: Dürfen ausländische Nutzer die Gewichte der stärksten Modelle weiter frei herunterladen? Die Financial Times ergänzte: auch Trainingsdaten und Chip-Entwürfe. Entschieden ist nichts, ein Entwurf liegt nicht vor; der Cloud-Zugang bliebe demnach wohl bestehen. Zur Debatte steht nicht, ob du diese Modelle benutzen darfst, sondern ob du sie noch herunterladen kannst. Nutzen dürfen oder haben: nicht dasselbe.
Was das für dich heißt
Der Vorfall bei Hugging Face ist kein Argument gegen KI, sondern eins gegen fremde Infrastruktur. Beim Download-Zugang ändert sich für dich heute nichts: Die Modelle liegen weiter da. Aber der Satz „das hol ich mir später mal" hat seine Unschuld verloren. Ein heruntergeladenes Modell veraltet, ja. Abgeschaltet wird es nicht, teurer auch nicht. Und es verhält sich nächsten Monat genauso wie heute.
Quellen
- https://huggingface.co/blog/security-incident-july-2026
- https://www.axios.com/2026/07/21/openai-says-hugging-face-breach-caused-by-one-its-models
- https://simonwillison.net/2026/Jul/22/openai-cyberattack/
- https://www.heise.de/en/news/Kimi-K3-Chinese-AI-finds-several-zero-day-vulnerabilities-in-redis-database-11377430.html
- https://github.com/redis/redis/releases/tag/8.6.5
- https://semgrep.dev/blog/2026/kimi-k3s-code-security-results-lack-precision/
- https://poolside.ai/blog/introducing-laguna-s-2-1
- https://huggingface.co/poolside/Laguna-S-2.1
- https://techcrunch.com/2026/07/09/popular-open-source-ai-developer-tool-ollama-raises-65m-grows-to-nearly-9m-users/
- https://thenextweb.com/news/china-curbing-overseas-access-top-ai-models
- https://thenextweb.com/news/china-ai-model-chip-export-controls-ft-report