MiniMax hat sein neues Modell frei zum Herunterladen veröffentlicht. Und in die eigene Lizenz geschrieben, dass Europa es nicht bekommt. Ein Anbieter veröffentlicht ein offenes Modell und entscheidet danach, für wen es offen ist. In derselben Woche passiert auf der anderen Seite das Gegenteil: Drei Modelle verschieben die Grenze dessen, was lokal überhaupt läuft.
Die Lizenz nennt deinen Wohnort
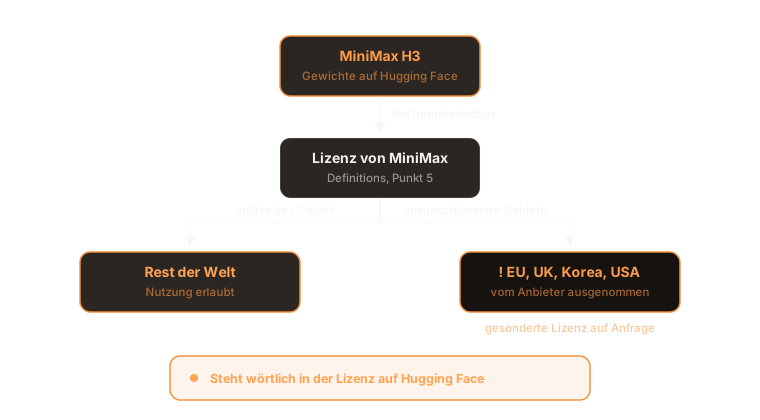
Am 3. August hat MiniMax die Basis-Gewichte von H3 auf Hugging Face gestellt: ein System, das Video mit Ton erzeugt, 33 Milliarden Parameter im Kern. Zwei Bausteine bleiben zu. Wer eine Betriebsart lokal fahren will, lädt rund 140 Gigabyte, für die meisten Maschinen ohnehin zu viel. Nur entscheidet das nicht deine Hardware, sondern die Lizenz.
Dort steht im Abschnitt „Definitions", Punkt 5: Ausgeschlossene Gebiete sind die Europäische Union, das Vereinigte Königreich, die Republik Korea und die USA. Zwei Absätze weiter die Konsequenz: Nutzen, kopieren, verändern, weitergeben oder anzeigen: nur innerhalb des zulässigen Gebiets, und das ist definiert als weltweit ohne diese Regionen.
In der Lizenz-FAQ stellt MiniMax es so dar: Die gehostete Schnittstelle bleibe global verfügbar, die Beschränkung gelte den Gewichten. Du darfst das Modell mieten, nur besitzen nicht. Im Lizenzvertrag selbst steht allerdings etwas anderes: Der zieht die gehosteten Dienste ausdrücklich in seinen Geltungsbereich. Zusage und Vertragstext sagen nicht dasselbe. Ich bewerte das nicht juristisch, ich zeige nur: Das steht da wirklich drin. Als Grund nennt MiniMax allgemein regulatorische Anforderungen; eine gesonderte Lizenz lässt sich anfragen.
Werkzeug der Woche: LFM2.5-2.6B, getestet auf Deutsch
Liquid AI hat am 4. August ein Modell mit 2,6 Milliarden Parametern veröffentlicht, trainiert auf Agenten-Arbeit. Die Q4-Fassung ist 1,7 Gigabyte groß. Erste Falle: ollama pull lfm2.5 holt nicht dieses Modell, sondern ein dreimal so großes mit 8 Milliarden Parametern. Der richtige Befehl: ollama pull hf.co/LiquidAI/LFM2.5-2.6B-GGUF:Q4_K_M.
Zum Tempo: Liquid nennt 220 Token pro Sekunde auf einem M5 Max, ich habe auf einem M4 Pro 64 gemessen. Eine Chip-Generation Unterschied, und von der Herstellerangabe bleibt kein Drittel übrig. Ohne die Hardware dahinter ist eine Tempo-Angabe wertlos.
Zur deutschen Qualität gibt es keine veröffentlichten Zahlen, also habe ich selbst gemessen: vier lokale Modelle, dieselbe Werkzeug-Aufgabe: ein Angebot anlegen, mit Betrag und Gültigkeitsdatum. Mit vollständigen Angaben lösen das alle vier. Dann habe ich das Datum weggelassen: 2 von 4 haben sich eins ausgedacht, beide aus der Vergangenheit. Ein drittes hat das Pflichtfeld einfach weggelassen. Nur das 2,6-Milliarden-Modell hat nachgefragt. Ein erfundenes Datum fängt keine Software ab. Der Aufruf sieht sauber aus. Und: Das Modell denkt auf Englisch, der deutsche Satz entsteht erst am Schluss als Übersetzung. Werkzeuge bedienen: ja. Kundentext ohne Gegenlesen: nein. Ein Durchgang pro Fall, kein Benchmark, aber in 5 Minuten nachbaubar.
Was jetzt wirklich auf die Maschine passt
DeepSeek hat am 31. Juli V4 Flash aktualisiert: 284 Milliarden Parameter, 13 Milliarden aktiv, MIT-Lizenz. Unsloth empfiehlt die 3-Bit-Fassung UD-IQ3_XXS mit 103 Gigabyte und mindestens 110 Gigabyte Speicher, RAM und VRAM zusammengerechnet. In der Vorwoche brauchte die kleinste Fassung eines anderen Modells noch 610 Gigabyte. Auf einer 128-Gigabyte-Maschine läuft das jetzt. Knapp.
Dazu: Alibaba hat Qwen3.8-Max vorgestellt: 2,4 Billionen Parameter, Gewichte angekündigt, ebenso eine offene 27-Milliarden-Fassung. Thinking Machines hat Inkling-Small veröffentlicht: ein Viertel der Größe des großen Inkling, beim Programmier-Test mit 80,2 zu 77,6 Prozent besser als das eigene Vorbild. Lokal läuft es mit mindestens 180 Gigabyte Grafikspeicher trotzdem nicht.
Und Kimi K3, das 1,5-Terabyte-Modell aus der Vorwoche: Jemand hat es auf 16 DGX Sparks laufen lassen: 21,7 Token pro Sekunde im Schnitt, Hardware rund 75.000 Dollar. Ein anderer hat es auf einer Grafikkarte von 2015 gestartet: Es läuft. Mit 10 bis 15 Minuten pro Token. In llama.cpp ist die Unterstützung weiter ein offener Pull Request.
Was das für dich heißt: der Zwei-Zeilen-Check
Bevor du ein Modell lädst, entscheiden zwei Zeilen, ob es für dich überhaupt in Frage kommt. Die erste steht in der Lizenzdatei: Darfst du es dort nutzen, wo du sitzt? Die zweite steht in der Modellkarte: Kennt deine Software die Architektur? Beide Zeilen liest fast niemand. Beide kosten dich einen Nachmittag, wenn du sie überspringst.
Quellen
- https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE
- https://huggingface.co/MiniMaxAI/MiniMax-H3
- https://www.liquid.ai/blog/lfm2-5-2-6b
- https://huggingface.co/LiquidAI/LFM2.5-2.6B
- https://api-docs.deepseek.com/updates/
- https://unsloth.ai/docs/models/deepseek-v4
- https://qwen.ai/blog?id=qwen3.8
- https://thinkingmachines.ai/model-card/inkling-small/
- https://forums.developer.nvidia.com/t/full-kimi-k3-running-on-16x-gb10-cluster/379174
- https://github.com/ggml-org/llama.cpp/pull/26185