Jede Zahl, die ich in einem Video über ein lokales Modell nenne, stammt aus demselben Prüfstand. Dieser Text beschreibt ihn so, dass du eine Messung nachvollziehen, nachrechnen und mit eigener Hardware wiederholen kannst. Er ist die Referenz, auf die jede künftige Messung hier verweist.
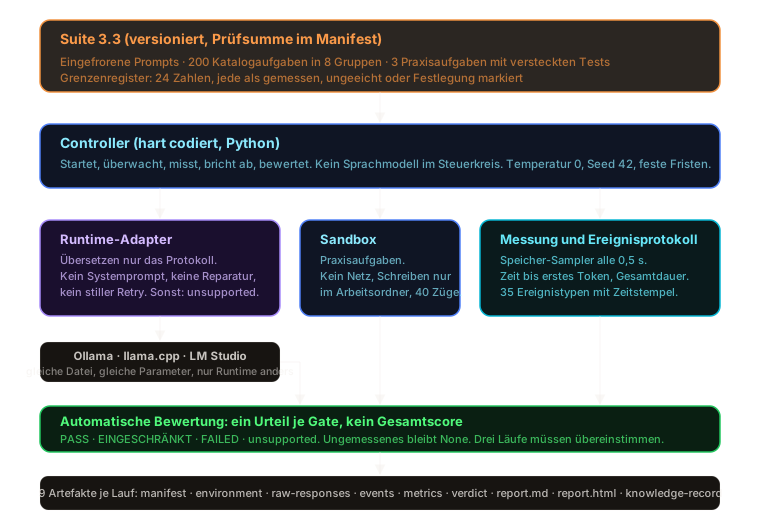
Die Kurzfassung: Ein hart codiertes Programm startet ein Modell, schickt ihm feste Aufgaben, misst Zeit und Speicher, bewertet nach festen Regeln und schreibt neun Dateien in einen Ordner. Kein Sprachmodell steuert die Messung. Es gibt keine Gesamtnote, sondern ein Urteil je Prüfung. Was nicht gemessen wurde, bleibt leer, statt zu 0 zu werden.
1. Die Frage, die der Prüfstand beantwortet
Was kann dieses Modell auf dieser Hardware, technisch, sprachlich und als Arbeitswerkzeug? Nicht: Welches Modell ist das beste? Ein Ranking würde voraussetzen, dass alle Nutzer dasselbe wollen. Ein Steuerberater braucht fehlerfreies Deutsch und einen sauberen Umgang mit Lücken. Ein IT-Leiter braucht Werkzeugaufrufe, die ein Skript weiterverarbeiten kann. Der Prüfstand liefert für jede dieser Anforderungen ein eigenes Urteil, und du filterst nach deiner.
2. Sieben Prinzipien
Diese Regeln stehen über jeder Bequemlichkeit. Wo eine davon verletzt wurde, steht es im Abschnitt 11.
Kein Sprachmodell im Steuerkreis. Ein Controller in Python startet, überwacht, misst, bricht ab und bewertet. KI-Werkzeuge dürfen den Prüfstand bauen, sie laufen im Benchmark nicht mit. Die einzige Ausnahme ist ein optionaler Richter, der nach dem Lauf Deutschantworten benotet. Sein Urteil ändert das Verdikt in keiner Richtung, es wird nur als Abweichung zur menschlichen Note ausgewiesen.
Adapter übersetzen nur. Die Anbindung an Ollama, llama.cpp oder LM Studio darf keinen Systemprompt einfügen, keine Antwort reparieren, nicht still wiederholen, keinen Timeout verlängern. Kann eine Runtime etwas nicht, lautet das Ergebnis unsupported. Es gibt keinen stillen Textparser, der einen Werkzeugaufruf aus Fließtext herausliest und als Erfolg zählt.
Modell ist nicht Runtime. Dasselbe Modell verhält sich unter Ollama anders als unter llama.cpp, wenn die Parameter nicht identisch sind. Ein Unterschied zwischen zwei Runtimes wird nie dem Modell zugeschrieben.
Einzelurteile statt Gesamtscore. Ein guter Durchschnitt versteckt ein durchgefallenes Gate. Es gibt neun unverrechnete Urteilszeilen je Lauf.
Geplant ist nicht gemessen. Ungemessenes bleibt None. Nicht False, nicht 0. Diese Unterscheidung zieht sich durch jeden Bewertungsschritt.
Reproduzierbarkeit vor Bestwert. Aufwärmlauf, dann mehrere Messläufe. Berichtet werden Median, Minimum und Maximum. Der beste Wert ist nie die Schlagzeile.
Keine Seiteneffekte. Programmieraufgaben laufen in einer Kapsel mit Standardverbot. Kein Netz, Schreiben nur im Arbeitsverzeichnis, frischer Ordner je Lauf.
3. Was genau gemessen wird: das Tupel
Ein Ergebnis gilt nur für die vollständige Kombination aus
| Bestandteil | Beispiel aus einem echten Lauf |
|---|---|
| Modell und Prüfsumme der Datei | gemma4:e4b, Digest c6eb396d… |
| Quantisierung | Q4_K_M |
| Runtime und Version | Ollama 0.34.0 |
| Startparameter | temperature 0, seed 42, num_ctx 16384, max_tokens 8192, Timeout 600 s |
| Hardware | Apple M4 Pro, 24 GB RAM |
| Betriebssystem | Darwin 25.6.0 |
| Suite-Version und Prüfsumme der Suite | 3.2, suite_digest 80876f23… |
Ändert sich ein Bestandteil, ist es eine andere Messung. Die Prüfsumme der Suite ist dabei der Beleg, die Versionsnummer nur die Behauptung: Zwei Läufe mit gleicher Nummer, aber verändertem Prompt, werden nicht zusammengeführt.
Seit Suite 3.2 steht zusätzlich die Kontextrechnung im Manifest: Kontextlänge des Modells, Speicherbedarf des Kontextspeichers je Token, Bedarf gegen freien Speicher vor dem Start.
4. Die sechs Gates
Ein Gate ist eine Prüfung mit eigenem Urteil. Die Urteile heißen PASS, EINGESCHRÄNKT und FAILED. Beim Speicher heißen sie HEALTHY, CONSTRAINED und FAILED. Dazu kommt unsupported, wenn die Runtime eine Fähigkeit nicht anbietet. Die Reihenfolge ist fest.
| Gate | Was gemessen wird | Urteilsregel |
|---|---|---|
| Startbarkeit | Runtime erreichbar, Modell lädt kalt, antwortet auf einen Minimalprompt, lädt warm nach | FAILED bei nicht erreichbar, Ladefehler oder keine Antwort. EINGESCHRÄNKT bei Kaltstart über 60 s oder wenn der Kaltstart nicht messbar war |
| Speicher | Prozessspeicher (Spitze), minimaler freier Systemspeicher, Swap-Out, Swap-In, komprimierter Speicher, alle 0,5 s abgetastet, unter Last durch einen Prompt mit 7841 Token | CONSTRAINED, sobald Swap-Out oder Swap-In über 64 MB, komprimierter Speicher über 512 MB oder freier Speicher unter 1024 MB. FAILED ohne Messproben oder bei abgebrochenem Chat |
| Geschwindigkeit | Zeit bis zum ersten Token, Prompt-Verarbeitung, Generierung und Gesamtdauer für drei Prompts (kurz, mittel, lang mit 5206 Token) | Ein Aufwärmlauf, drei Messläufe. Median, Min, Max. FAILED bei Abbruch, EINGESCHRÄNKT bei abgeschnittener oder fehlender Antwort |
| Deutsch | 125 Katalogaufgaben in fünf Gruppen. Automatisch: Pflichtbegriffe, verbotene Begriffe, Wortgrenze, Format, Zahlenschreibweise, Sprache. Danach menschliche Blindbewertung | Ein einziger automatischer Verstoß setzt FAILED. Ohne menschliche Bewertung bleibt es EINGESCHRÄNKT. PASS, wenn der Median der menschlichen Noten mindestens 3 von 4 ist |
| JSON | Eine Antwort gegen ein festes Schema, ohne Reparatur | Sechs Einzelprüfungen: gültiges JSON, Datentypen, Pflichtfelder, Wertebereiche, keine Zusatzfelder, Null-Felder nicht erfunden |
| Werkzeugaufrufe | 75 Katalogaufgaben mit sechs simulierten Werkzeugen (Dokumentsuche, Metadaten, Kalender, Lesen, Websuche, Mail) über zwei Gesprächsrunden | Acht Prüfungen: richtiges Werkzeug, kein unnötiger Aufruf, Pflichtargumente, gültige Argumente, Lücke erkannt, nichts erfunden, sinnvolle Fortsetzung, Reaktion auf einen defekten Rückgabewert |
Alle Schwellen im Speicher-Gate und die 60 Sekunden beim Kaltstart sind Festlegungen, keine Messungen. Das Register der Grenzen in Abschnitt 8 weist sie so aus.
Drei weitere Diagnosen laufen bei jedem Lauf mit, ohne Urteil: eine Heuristik auf stille Kürzung des Prompts durch die Runtime, die Randlagenprüfung aus Abschnitt 8 und die Aufteilung der Rechenlast zwischen GPU und CPU.
5. Der Aufgabenkatalog
Seit Suite 3.3 enthält der Katalog 200 Aufgaben in acht Gruppen zu je 25. Fünf Aufgaben je Gruppe sind nicht veröffentlicht. Sie bilden eine Reserve, die zeigt, ob ein Modell die veröffentlichten Aufgaben gelernt hat statt die Fähigkeit.
| Gate | Gruppe | Was sie prüft |
|---|---|---|
| Deutsch | Verdichtung | Zusammenfassen mit Wortgrenze, ohne Kopie |
| Deutsch | Strukturierte Entnahme | Werte aus Fließtext in eine vorgegebene Form bringen |
| Deutsch | Register und Varianten | Tonlage wechseln, Schweizer und österreichische Schreibweisen |
| Deutsch | Nachfragen statt Raten | Bei fehlender Information fragen statt Platzhalter liefern |
| Deutsch | Vorsortierung im Text | 23 Dokumente einer Kategorie zuordnen und die Fundstelle wörtlich zitieren |
| Werkzeuge | Werkzeugwahl und Argumente | Das richtige Werkzeug mit gültigen Argumenten |
| Werkzeuge | Fehler und Lücken | Defekte Rückgaben erkennen, nichts erfinden |
| Werkzeuge | Vorsortierung per Werkzeug | Dieselbe Sortierung, aber über Dokumentsuche und Lesen |
Jede Aufgabe trägt ihre Bedingungen als Daten. Aus der Zahl der Bedingungen leitet der Loader eine Schwierigkeitsstufe ab: eine Bedingung ist Stufe 1, zwei bis drei sind Stufe 2, ab vier oder bei einer unbenannten Lücke Stufe 3. Die Zählregeln sind schriftlich fixiert, und eine Aufgabe, deren Stufe nicht zur Regel passt, wird beim Laden abgewiesen.
Dazu kommen drei Programmieraufgaben in aufsteigender Schwierigkeit: ein Kommandozeilenwerkzeug, das Markdown in einen deterministischen JSON-Bericht wandelt (17 versteckte Tests), eine idempotente Dokumenteneingangs-Pipeline mit Regeldatei und Probelauf (20 Tests) und eine Wissensdatenbank mit SQLite und Volltextsuche (22 Tests).
Wie bewertet wird
Automatisch und deterministisch. Formattreue, Sprache, Pflicht- und Verbotsbegriffe mit Wortgrenzen-Abgleich, Zahlenschreibweise nach DIN 5008, Werkzeugaufrufe gegen erwartete Treffer. Bei der Vorsortierung wird das Zitat wörtlich gegen das Dokument geprüft, fünf bis vierzig Wörter, und daraus ein Nacharbeitszustand abgeleitet: direkt verwendbar, prüfen, falsch. Der wird gezählt, nicht verrechnet.
Menschlich. Für die Deutschaufgaben benotet ein Mensch die Antworten blind, in zufälliger Reihenfolge, auf einer Skala von 1 bis 4. Nur dieser Median entscheidet über PASS.
Gruppenauswertung. Je Gruppe stehen Treffer von 25, ein 95-Prozent-Wilson-Intervall, und ob der Anteil über der Schwelle von 80 Prozent liegt. Die Schwelle ist eine Festlegung. Liegt das Intervall ganz auf einer Seite der Schwelle, gilt das Ergebnis als gesichert, sonst nicht. Bei 20 von 25 lautet das Intervall 0,61 bis 0,91, die Schwelle liegt also darin. Das steht dann so im Bericht.
Zweitprüfung der Einstufung. Ob die Stufenregel eindeutig ist, wurde in mehreren Runden geprüft: Zwei Prüfer stufen dieselben 100 Aufgaben unabhängig ein. Rohe Übereinstimmung: 78 von 100 in Runde 1, danach wurden fünf Regelfragen geklärt, 96 und 94 von 100 in den Nachmessungen, 48 von 50 bei den Werkzeuggruppen, 25 von 25 bei der Vorsortierung. Gemessen ist damit die Eindeutigkeit der Regel, nicht die Schwierigkeit für ein Modell. Die letzten Runden wurden von KI-Subagenten ohne Katalogzugang durchgeführt, mit festem Seed. Das ist in jedem Protokoll vermerkt.
6. Ablauf eines Laufs
- Die Suite wird geladen und validiert: Pflichtfelder, Dateien, Stufenableitung.
- Der Adapter startet die Runtime. Vorprüfung: mindestens 2 GB freier Plattenplatz, kein fremdes Modell im Speicher, Kontextbedarf gegen freien Speicher.
- Ein Laufordner entsteht, benannt nach UTC-Zeitstempel, Modell und Profil. Manifest und Umgebungsdatei werden geschrieben. Der Speicher-Sampler beginnt.
- Die Gates laufen in fester Reihenfolge. Gesamtfrist 4 Stunden, Frist je Anfrage 10 Minuten. Wird die Gesamtfrist gerissen, tragen die übersprungenen Gates den Grund
run_timeout. - Bei Programmieraufgaben bekommt das Modell sechs Werkzeuge (Dateien listen, lesen, schreiben, Befehl ausführen, Tests ausführen, fertig melden), höchstens 40 Züge und eine Stunde. Erlaubt sind zwölf Befehle. Danach wird das Arbeitsverzeichnis eingefroren, der Controller ruft das Programm in der Kapsel auf, und der versteckte Test urteilt nur über das entstandene Artefakt. Er führt keinen Modellcode aus.
- Runtime-Kennzahlen, Stopp, Bewertung, Schemaprüfung aller Ausgabedateien, atomarer Tausch in den Laufordner. Status
completed, bei Abbruchaborted_lab_erroroderinterrupted.
Jedes Ereignis landet mit Zeitstempel im Ereignisprotokoll: Modell geladen, Anfrage gesendet, Antwort empfangen, Speicherprobe, Werkzeugergebnis, Werkzeug nicht unterstützt, fehlgeformter Aufruf, Zeitüberschreitung, Prozesswechsel, Fremdbelegung der Runtime. 35 Ereignistypen insgesamt.
Ein Verdikt braucht drei übereinstimmende Läufe. Der Nachtlauf fährt jedes Modell dreimal mit getrennten Ladevorgängen und entlädt zwischen den Modellen. Stimmen die Läufe nicht überein, heißt das Urteil uneinheitlich, bei weniger als drei Läufen unbestätigt. Ein unbestätigtes PASS ergibt keine Freigabe. Ein unbestätigtes FAILED bleibt eine Sperre.
7. Was ein Lauf hinterlässt
Neun Dateien je Lauf, jede gegen ein Schema geprüft:
| Datei | Inhalt |
|---|---|
| manifest.json | Das Tupel aus Abschnitt 3, Harness-Version, Startparameter, Kontextrechnung, Status |
| environment.json | CPU, Kerne, Architektur, OS-Version, Python-Version, RAM |
| raw-responses.jsonl | Jeder Prompt und jede Antwort unverändert |
| events.jsonl | Das Ereignisprotokoll |
| metrics.json | Alle Messwerte je Gate, Gruppenauswertung, Diagnosen |
| verdict.json | Die Urteile mit Gründen, Suite- und Bewertungsversion |
| report.md | Lesbarer Prüfbericht mit Warnkasten, Verdikt, Messwerten, Gruppen, Nacharbeit |
| report.html | Derselbe Bericht als HTML |
| knowledge-record.md | Kurzer Wissensbaustein für die spätere Wissensbasis |
Programmieraufgaben legen zusätzlich die Programmaufrufe, den finalen Diff, die geänderten Pfade und die Testausgaben ab. Eine menschliche Bewertung kommt nachträglich als eigene Datei dazu. Wird ein Lauf neu bewertet, wandert die alte Bewertung in einen Unterordner, nichts wird überschrieben.
8. Grenzen und Eichung
Jede Zahl in der Suite, die eine Messung begrenzen kann, steht in einem Register mit drei Zuständen:
- gemessen: gegen ein Modell geeicht, mit Datum und Befund
- ungeeicht: ein Deckel ohne Messung, der die Messung verfälschen kann
- Festlegung: eine Urteilsschwelle, die man nicht messen, nur entscheiden kann
Stand heute: 24 Grenzen, 13 gemessen, 4 ungeeicht, 7 Festlegungen. Ein Test wird rot, sobald eine Zahl ohne Registereintrag in die Suite kommt. Ungeeicht sind noch die maximale Zugzahl und der Timeout der Programmieraufgaben, der Mindestplattenplatz und das Sampler-Intervall.
Der Eichlauf schickt jeden Messpunkt einmal mit weit geöffneten Deckeln (Kontext 32768, Antwort 16384 Token) und stellt den tatsächlichen Bedarf gegen die konfigurierte Grenze. Er urteilt nicht und ändert nichts. Der Eichlauf vom 12. September 2026 mit qwen3:4b (159 Messpunkte, 111 Minuten) fand 76 Messpunkte über dem damaligen Antwortdeckel von 2048 Token. Denkende Modelle brauchen 3000 bis 8000 Token, bevor 50 Token Antwort kommen. Die Folge war Suite 3.2 mit neuen Deckeln.
Die Randlagenprüfung läuft in jedem Lauf mit: Je Gate wird der größte Prompt- und Antwortbedarf gegen die Deckel aus dem Manifest gehalten. Ab 80 Prozent Auslastung steht randlage: true im Bericht. 2045 von 2048 Token sind kein Erfolg, sondern Glück.
9. Profile: eine Datei, drei Runtimes
Drei Profile teilen sich Modelldatei und Prüfsumme, Quantisierung, Prompts, Werkzeugschemas, Fixtures, Temperatur 0, Seed 42, Deckel, Wiederholungen, Timeouts und Bewertungsregeln. Nur Runtime, Version und Adapterparameter unterscheiden sich.
| Profil | Runtime | Besonderheit |
|---|---|---|
| ollama | Ollama | Kontext je Anfrage, native Ladezeit, Kaltstart über Entladen mit Nachprüfung |
| core | llama.cpp llama-server | Direkter GGUF-Pfad, Kaltstart ist Prozessstart bis Gesundheitsprüfung, Kontext wird über die Serverkonfiguration gesetzt und nachgeprüft |
| lmstudio | LM Studio | Keine Teilzeiten, keine Prüfsumme über die API, Laden nur über die Kommandozeile |
Gemessen am 14. September 2026: qwen3:4b aus demselben Ollama-Blob liefert unter Ollama 0.34.0 und llama.cpp b10470 identische Gate-Urteile, identische Gruppenzahlen bis auf eine Aufgabe, 115 von 210 Antworten mit exakt gleicher Tokenzahl, Zeiten innerhalb von 4 Prozent. Das Gegenbeispiel: Gemma 3 aus der Ollama-Bibliothek lädt in llama.cpp gar nicht. Dort wären zwei Runtimes zwei Dateien, und der Vergleich wäre unzulässig.
Ein MLX-Profil gibt es nicht. Ob es nötig ist, entscheidet ein Vergleich von Gemma 4 unter Ollama gegen LM Studio. Nur bei gemessenem Unterschied wird gebaut.
10. Was schiefging und was daraus wurde
In den ersten beiden Tagen fand der Prüfstand sechs Konfigurationsfehler. Jeder sah zuerst aus wie eine Eigenschaft des Modells.
| Beobachtung | Tatsächliche Ursache |
|---|---|
| Modell kürzt den langen Prompt still | Kontext global auf 4096, Ollama kürzte auf 2050 von 5206 Token |
| Modell ruft keine Werkzeuge | Antwortdeckel 2048 bei Bedarf 2700, das Modell endete beim Denken |
| Modell ruft keine Werkzeuge | Die eigene Handsonde hatte 300 Token Deckel |
| Bericht widerspricht dem Manifest | Der Bericht zeigte den globalen Wert, nicht den des Gates |
| Speicher-Gate unbrauchbar | Antwortdeckel 512 bei Bedarf 917 |
| Größtes Modell startet nicht | Ein Band, in dem Ollama 0.32.5 mit Rechenfehler abbricht: 2048 ok, 3072 ok, 4096 bis 6144 Fehler, 8192 ok. Per curl ohne Lab-Code reproduziert |
Der letzte Fall ist der lehrreichste. Der Wert stand seit Suite 1.0 im eigenen Register als ungeeicht. Der Prüfstand hatte aufgeschrieben, dass er dieser Zahl nicht trauen kann. Gefunden wurde der Fehler trotzdem erst durch die Nachfrage eines Menschen. Daraus entstanden Register, Eichlauf und Randlagenprüfung.
Weitere Lehren, die heute als Regel im Repository stehen:
- Nie zwei Läufe gegen dieselbe Runtime. Zwei parallele Läufe erzeugten abweichende Tokenzahlen bei Temperatur 0 und einen unmessbaren Kaltstart. Beides wurde zuerst als Umgebungsgrenze fehldiagnostiziert.
- Die Sandbox verlor viermal gegen Kopien des Maßstabs. Das Modell fand Kopien der Testdateien in Lesepfaden. Seither ist Lesen außerhalb einer gemessenen Erlaubnisliste verboten, und ein Vorlauf sucht nach Kopien per Inhaltshash.
- Der Mac schlief im Nachtlauf. Ab 05:54 im 15-Minuten-Takt, ein mittlerer Prompt brauchte 963 s Wanduhr bei 68 s Rechenzeit. Zeit- und Speicherwerte dieser Nacht sind ungültig, die Gruppenergebnisse gültig. Der Nachtlauf startet seither unter
caffeinate. - Eine konfundierte Messung bleibt im Changelog stehen, mit Korrektur. Sie wird nicht gelöscht.
11. Aktuelle Ergebnisse
Hardware: Apple M4 Pro, 24 GB RAM. Alle abgeschlossenen Läufe liegen unter Suite 3.2. Der Katalog ist bereits 3.3, ein Lauf damit steht aus.
| Modell | Runtime | Start | Speicher | Speed | Deutsch | JSON | Werkzeuge |
|---|---|---|---|---|---|---|---|
| qwen3:4b Q4_K_M | Ollama 0.34.0, 3 Läufe | PASS | CONSTRAINED | PASS | FAILED | PASS | FAILED |
| qwen3:4b, derselbe Blob | llama.cpp b10470 | PASS | CONSTRAINED | PASS | FAILED | PASS | FAILED |
| gemma4:e4b Q4_K_M | Ollama 0.34.0 | PASS | CONSTRAINED | PASS | FAILED | PASS | FAILED |
| gemma3:4b Q4_K_M | Ollama 0.34.0 | PASS | CONSTRAINED | PASS | FAILED | FAILED | unsupported |
Treffer je Gruppe von 25, in der Reihenfolge Werkzeugwahl, Fehler und Lücken, Nachfragen, Register, Entnahme, Verdichtung:
| Modell | Werkzeugwahl | Fehler | Nachfragen | Register | Entnahme | Verdichtung |
|---|---|---|---|---|---|---|
| qwen3:4b (Ollama) | 24 | 17 | 8 | 12 | 23 | 22 |
| qwen3:4b (llama.cpp) | 25 | 17 | 8 | 12 | 23 | 22 |
| gemma4:e4b | 24 | 22 | 14 | 19 | 22 | 15 |
| gemma3:4b | unsupported | unsupported | 9 | 9 | 13 | 18 |
Was diese Tabelle zeigt und was nicht: Kein Modell besteht das Deutsch-Gate, weil es konjunktiv über 125 Aufgaben ist und jeder automatische Verstoß durchfällt. Die Gruppenzahlen sind die aussagekräftigere Ebene. Bei qwen3:4b ist das Fehlerbild scharf: In "Nachfragen statt Raten" liefert es Platzhalter statt Rückfragen (8 von 25), bei Registern fehlt das Lexikon der Varietäten (12 von 25). Gemma 4 fragt besser nach, verdichtet aber schlechter. Nur eine einzige Gruppe eines Modells ist "bestanden und gesichert": Werkzeugwahl bei gemma4:e4b mit 24 von 25 und Intervall 0,805 bis 0,993.
Ausgewählte Rohwerte aus dem gemma4-Lauf: Kaltstart 18,5 s, Warmstart 1,9 s, Prozessspeicher-Spitze 6940 MB, Swap-In 22 679 MB, minimal frei 1919 MB. Geschwindigkeit kurz, mittel, lang: Median 10,0 s, 12,5 s, 12,4 s bei 592, 731 und 695 Token. qwen3:4b generiert im langen Fall 4065 Token in 70 s, rund 58 Token pro Sekunde. Nur auf der CPU sind es 9,5 Token pro Sekunde, und die Antworten sind nicht tokenidentisch.
Die ältere Grundlinie aus Suite 2.8 (August 2026, fünf Modelle, Ollama 0.32.5) ist damit nicht vergleichbar. Ihre zentralen Befunde: Nur qwen3:8b bestand Werkzeugaufrufe, ein ausdrückliches Coding-Modell gab Werkzeugaufrufe als Text aus, devstral:24b holte in einem Lauf 62 GB aus dem Swap zurück, und von 17 Programmierläufen bestand keiner. Bestes Ergebnis: 9 von 17 versteckten Tests.
12. Was das Verfahren nicht kann
Diese Liste ist Teil der Dokumentation, nicht eine Fußnote.
- Eine Maschine, ein Betriebssystem. Alle Zahlen gelten für einen M4 Pro mit 24 GB unter macOS. Die Sandbox-Erlaubnisliste ist nur für Homebrew-Python 3.13 gemessen.
- Menschliche Bewertung ist unkalibriert. Zwei deutlich verschiedene Antworten landeten bei 23 und 24 von 24 Punkten. Das Urteil derselben Person änderte sich nach Sicht einer zweiten Antwort. Zwei unabhängige Richter mit versioniertem Prompt und Referenzfällen sind entworfen, nicht gebaut.
- Keine Interrater-Statistik. Die Zweitprüfungen berichten rohe Übereinstimmung. Krippendorffs Alpha mit ordinaler Distanz und Schwelle 0,8 ist die geplante Kennzahl, sie wird erst gerechnet, wenn die Richter laufen. In einer Runde war die Isolation der Prüfer nicht sauber, der zweite Prüfer kannte Projektkontext.
- 25 Aufgaben je Gruppe sind wenig. Die Intervalle sind breit, Stufen tragen kein Intervall, Wiederholungen desselben Modells sind keine unabhängigen Beobachtungen. Keine Signifikanztests, keine Item-Analysen.
- Konstruktvalidität ist nicht geprüft. Ob eine Gruppe wirklich die Fähigkeit misst, die ihr Name verspricht, wurde nicht extern zugeordnet. In zwei Gruppen kippt die Stufenordnung: Stufe 3 wird häufiger gelöst als Stufe 2.
- Kontamination ist nur teilweise adressiert. Die 20 Prozent Reserve existiert. Ein Canary, das Trainingsdatum des Modells und das Veröffentlichungsdatum der Suite stehen noch nicht im Manifest.
- Deckel sind an einem Modell geeicht. Für ein denkendes Modell gibt es keinen endlichen Antwortdeckel, der garantiert nicht bindet.
- Programmieraufgaben ohne 3.x-Lauf. Unter 2.x bestand keins. Ein einzelner Praxislauf trägt keine Aussage, derselbe Fingerabdruck lieferte verschiedene Ergebnisse.
- Stufe 1 ist bei Sprache nicht angriffsfest. Eine Verdichtung besteht per wörtlicher Kopie, wenn die Wortgrenze über der Quelle liegt. Das ist eingefroren und dokumentiert, nicht behoben.
- Aufgaben sind KI-unterstützt entstanden. Aufgaben und Kriterien wurden mit Claude und Codex erarbeitet und von mir geprüft. Das gehört offengelegt.
- Quellformen wie Word, PDF und Scan sind für Suite 3.4 spezifiziert, nicht gebaut.
13. Selbst messen
Der Prüfstand ist ein Python-Paket. Voraussetzungen: Ollama läuft mit leerem ollama ps, kein anderer llama-server auf Port 8081, der Rechner darf nicht schlafen, und es läuft nie ein zweiter Lauf gegen dieselbe Runtime.
python -m lab run --model qwen3:4b --profile ollama
Weitere Einstiege:
python -m lab run --model /pfad/modell.gguf --profile core --cpu-only
python -m lab practice --model qwen3:4b --profile ollama --task local-doc-report
python -m lab nightrun --models qwen3:4b,gemma4:e4b --profile ollama
python -m lab verdikt --runs-dir runs
python -m lab grenzen
python -m lab eichen --model qwen3:4b --profile ollama
python -m lab evaluate runs/20260915T043115Z_gemma4-e4b_ollama --no-judge
Exit-Code 0 bedeutet: gemessen, auch wenn das Modell versagt hat. Das ist ein Ergebnis. Exit-Code 2 bedeutet einen Fehler des Prüfstands selbst. Diese Trennung ist Absicht.
14. Versionierung
Die Suite bekommt eine neue Version bei jeder Änderung an Prompt, Fixture, Werkzeugschema, verstecktem Test, Aufgabe oder Bewertungsregel. Archivierte Läufe werden nie neu bewertet. Hauptversionen werden nie in einer Tabelle gemischt.
| Version | Schritt |
|---|---|
| 1.0 | Prompts eingefroren, drei technische Gates |
| 1.1 bis 1.2 | Deutsch, JSON, Werkzeuge |
| 1.3 bis 1.9 | Drei Programmieraufgaben, versteckte Tests urteilen nur über Artefakte |
| 1.10 bis 1.12 | Swap und komprimierter Speicher, Empfehlungsregeln |
| 2.0 | Sechs JSON- und acht Werkzeug-Einzelprüfungen |
| 2.1 bis 2.8 | Kontext je Gate nach gemessener stiller Kürzung, erster Eichlauf-Befund |
| 2.9 | Drei Wiederholungen, unbestätigt und uneinheitlich als Urteile |
| 3.0 | Fähigkeitsgruppen, Stufen als Daten, Wilson-Intervall, Zweitprüfungen |
| 3.1 | 150 Katalogaufgaben |
| 3.2 | Deckel nach Eichlauf, Kontextrechnung vor dem Start, CPU-only |
| 3.3 | Vorsortierung mit Fundstellen, 200 Aufgaben, 23 Dokumente |
| 3.4 | Geplant: Quellformen Word, PDF, Scan |
Quellen und Einordnung
Die methodische Einordnung folgt zwei Arbeiten: Reuel et al., BetterBench (2024), und Bean et al. (2025) zu Validität von LLM-Benchmarks. Vorhanden sind Versionierung, Unveränderlichkeit archivierter Läufe, Verzicht auf Gesamtscore, Ausweisen von Ungemessenem und ein vollständiges Manifest. Die benannten Lücken sind Unsicherheitsangaben, Itemqualität, Absicherung der Richter und Kontaminationsschutz. Sie stehen in Abschnitt 12.
Das Wilson-Intervall ist nach Brown, Cai und DasGupta (2001) implementiert. Die Zahlenschreibweise folgt DIN 5008.
Jede künftige Messung auf dieser Seite verweist auf diesen Text und nennt Suite-Version, Hardware und Laufkennung. Ändert sich das Verfahren, ändert sich der Stand oben im Kopf.